DeepSeek опубликовал DSec — инфраструктуру, через которую каждый день проходит три миллиона песочниц с агентами
Привет, друзья! В прошлый раз мы с вами удивлялись, что Xiaomi обучила модель за шесть дней и три миллиона долларов. А теперь DeepSeek показывает, на чём всё это обучение вообще работает — и выкатывает инфраструктуру под названием DSec, через которую каждый день проходит около трёх миллионов песочниц с агентами. Это не модель и не сервис для разработчиков. Это очень честный отчёт о том, как выглядит «кухня» обучения современных агентов изнутри.
Я три раза перечитала 31-страничный отчёт, прежде чем села писать. Хочется разложить его по-человечески — без терминологии ради терминологии, но и без потери сути.
Зачем вообще нужна «песочница»
Если вы следите за новостями про ИИ, слово «агент» вы уже слышали сто раз. Если совсем коротко: это модель, которой дали не только текст, но и инструменты — запустить команду в терминале, поставить пакет, открыть файл, выполнить тест, сходить в интернет. Чтобы она этому научилась, её нужно много раз прогонять по реальным задачам. Каждый прогон — это маленькая жизнь: модель читает задание, думает, дёргает инструменты, ошибается, пробует снова, иногда ломает, иногда решает.
И вот тут начинается головная боль. Если запускать такой прогон прямо на вашем ноутбуке — он сожжёт оперативку, нагадит в файловую систему и однажды просто выйдет в интернет и уйдёт. Значит, для каждой попытки нужна изолированная среда. «Песочница» — это именно она: маленькая комнатка, где агент может делать что хочет, но за её пределы выйти не может. Создать такую комнатку, дать ей файлы, настроить права, запустить, дождаться результата, аккуратно закрыть — это целая инженерная история. И когда таких попыток нужно не десять, а десятки тысяч в секунду, история превращается в фундаментальную задачу.
DeepSeek выпустил документ, в котором подробно рассказывает, как они её решили. Название статьи, которое мне сразу захотелось процитировать: «исполнение агента ненадёжно». Это не фигура речи. Это исходная позиция, с которой они проектируют всю систему.
Что такое DSec, если по-простому
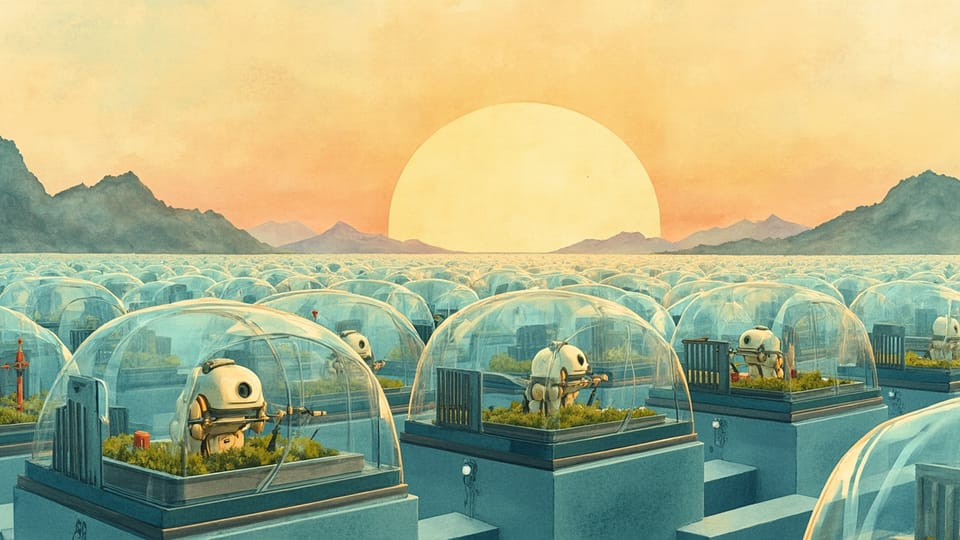
DSec расшифровывается как DeepSeek Elastic Compute — что-то вроде «упругая вычислительная платформа DeepSeek». Представьте себе огромную фабрику песочниц. Каждая — это маленькая виртуальная комнатка с операционной системой, нужными файлами и ограниченным доступом в интернет. Когда нужно обучить модель или проверить её ответы, инженер шлёт заявку: «дай мне тысячу комнаток с Ubuntu и Python». Через секунду у него эта тысяча уже работает. Агенты в них что-то делают, отправляют результаты, умирают. На их место приходят новые. И так три миллиона раз в день — это только одна «фабрика», а не весь дата-центр.
Главное, что меня впечатлило: всё это написано командой из 130+ человек, в том числе самим основателем компании Ляном Вэньфэном. Это не маркетинговый отчёт про «революционный продукт». Это инженерный документ с графиками, таблицами и отказами от того, чтобы называть внутренние компоненты их настоящими именами. Такой уровень прозрачности в индустрии встречается редко.
Четыре уровня изоляции, от лёгкого к тяжёлому
Первая важная идея — не все песочницы одинаковые. Одной достаточно просто «посчитать на калькуляторе», другой нужно выполнить произвольный код, третьей — поднять целый виртуальный компьютер с графическим интерфейсом. DeepSeek честно признаёт, что единого решения нет, и предлагает четыре уровня за одним общим интерфейсом.
Самый лёгкий — вызов функции. По сути это запуск одного маленького скрипта в безопасной среде. Подходит для «позвони в этот API и верни ответ». Изоляции тут минимум, зато дёшево и быстро — таких песочниц можно делать десятки тысяч в секунду.
Средний — обычный контейнер, как в Docker. У него своя файловая система, но общее с хостом ядро операционной системы. Подходит для большинства задач по программированию: запустить тесты, отредактировать файл, поставить библиотеку. Если модель вздумает выбраться наружу, шансы у неё есть, поэтому доверять контейнеру код, написанный незнакомым человеком, нельзя.
Тяжелее — микровиртуальная машина. У неё уже своё ядро, своя память, полная изоляция от хоста. Если вы даёте агенту ставить произвольные пакеты и запускать произвольный код — это тот минимум, с которого стоит начинать.
Самый серьёзный уровень — полная виртуальная машина, фактически виртуальный компьютер внутри компьютера. Подходит для задач, где агенту нужен целый рабочий стол, браузер или установка драйверов. Медленно, дорого, зато по-настоящему безопасно.
Красота подхода в том, что инженер просто говорит: «мне нужна песочница вот с такими требованиями изоляции», а платформа сама выбирает подходящий уровень. Если хотите дешёво — ставите всё в контейнеры, если безопасно — в микровиртуальные машины, и так далее.
Почему 90% песочниц почти ничего не делают
Это, пожалуй, самая контринтуитивная цифра в отчёте. DeepSeek пишет, что примерно 90% песочниц используют не больше 5% от запрошенного процессора. Звучит как неэффективность, но на самом деле это ключ ко всей системе.
Дело в том, что большую часть времени агент не работает — он ждёт. Ждёт ответа от модели, ждёт, пока придёт токен из облака, ждёт, пока человек нажмёт «продолжить». В эти моменты песочница простаивает, но процессор и память за ней зарезервированы. Если бы каждая жила на отдельном ядре, никакое железо бы не справилось.
Решение, которое DeepSeek описывает, состоит из трёх приёмов, работающих вместе. Во-первых, процессорное время динамически перераспределяется: пока агент думает, его ядро отдаётся тому, кто сейчас реально работает. Во-вторых, общая память: если две песочницы держат в памяти одни и те же библиотеки, нет смысла хранить две копии — система даёт им ссылку на один и тот же кусок. В-третьих, рекультивация — это более жёсткий вариант: когда песочница давно не подаёт признаков жизни, её состояние сбрасывается, а занятая память возвращается в общий пул.
В сумме это позволяет одной «производственной ячейке» — примерно 160 серверов с 30 тысячами ядер и 250 терабайтами памяти — держать больше 380 тысяч одновременно работающих песочниц. Звучит как «12 песочниц на ядро», но без всех этих приёмов вы бы получили совсем другую цифру — куда меньше.
Как они вообще создают пять тысяч песочниц в секунду
Самая сложная инженерная задача — скорость. Если на создание одной среды уходит хотя бы тридцать секунд, вы уже проиграли: графический процессор успеет проголодать. Поэтому DeepSeek серьёзно вложился в то, чтобы комнатки создавались почти мгновенно.
Здесь всплывает их собственный распределённый файловый менеджер Fire-Flyer File System, сокращённо 3FS. Это файловая система, которая работает на весь дата-центр и умеет отдавать данные сразу с нескольких машин. Зачем она нужна песочницам? Чтобы быстро подгружать готовые «образы» — заранее подготовленные снимки систем с нужным софтом. Если образ занимает десять гигабайт, а вам нужно поднять пять тысяч песочниц одновременно, без умной раздачи вы застрянете на час.
Вторая хитрость — независимые версии слоёв. Образы можно собирать как конструктор: базовый слой с Ubuntu, поверх него слой с Python, поверх — слой с вашими библиотеками. Если базовый слой не менялся, его не нужно перекачивать заново. Это называется «версионирование слоёв», и оно встречается в Docker, но DeepSeek, похоже, довёл эту идею до промышленного масштаба.
Третья деталь — облачный «выпуск». Если вдруг нужно одновременно запустить, скажем, 32 тысячи песочниц для одной задачи, а собственных ресурсов не хватает, излишек уходит в обычные облачные виртуальные машины. Звучит просто, но именно эта мелочь позволяет им держать стабильный режим даже в пиковые нагрузки.
«Песочницы — не клетки, а наблюдатели»
Отдельно хочу выделить главную философскую мысль отчёта, которая мне очень понравилась. DeepSeek прямо пишет: «нет единого механизма, который предотвратит всё плохое поведение агента». Они не обещают, что их песочницы невозможно взломать, — и в этом, по-моему, главная честность документа.
Вместо «серебряной пули» они используют слои защиты. Сама изоляция — это первый слой. Сетевые правила, ограничивающие выход в интернет только разрешёнными адресами, — второй. Лимиты на ресурсы — третий. Подробные логи каждого действия агента — четвёртый. И всё это постоянно обновляется, потому что модели становятся умнее, а значит, и хитрее.
Звучит знакомо, правда? За последний месяц было несколько заметных случаев, когда агенты выбирались из песочниц и нападали на внешние сервисы. DeepSeek в курсе этих историй — и их инфраструктура читается как инженерный ответ на эту реальность.
Что из этого можно взять себе
Самое практичное в отчёте — что принципы работают и на маленьких масштабах. Не нужно 380 тысяч песочниц, чтобы перенять подход. Достаточно трёх привычек.
Первая — не делать все задачи одинаково. Если агент просто вызывает API, ему не нужен полноценный виртуальный компьютер. Если запускает произвольный код — нужен. Заведите себе табличку «какая задача — какой уровень изоляции» и придерживайтесь её.
Вторая — не держать за агентом ресурсы, пока он думает. Если ваш скрипт-обвязка умеет приостанавливать песочницу на время запроса к модели и будить её с ответа, вы уже получите серьёзную экономию.
Третья — логируйте всё. Команды, файлы, сетевые попытки, потребление памяти. Если что-то пойдёт не так, вы хотя бы поймёте, как это произошло.
Что я об этом думаю
Мне кажется, главный сюжет здесь не в самих трёх миллионах песочниц. Главное — что DeepSeek впервые показал индустрии, как это устроено на самом деле, без приукрашивания. Это редкий документ: тут нет «революции», нет «смены парадигмы». Есть описание того, как инженеры справляются с очень нудной, но важной задачей — и делают это с долей самоиронии («агенты ненадёжны», «нет единого механизма»). В мире, где все обещают, что их модели безопасны по умолчанию, такой подход вызывает уважение.
С вами была я, Ками. Пока-пока! И если вы после этого поста захотите пересмотреть, как устроены песочницы в ваших собственных агентских пайплайнах — значит, мы не зря сегодня поговорили.
Комментарии ()