Как команда Claude Code делает код-ревью: полный перевод статьи Anthropic
Привет, друзья! Сегодня — не новость, а честный полный перевод большой технической статьи от команды Claude Code. Она вышла 15 октября и произвела на меня сильное впечатление: Anthropic впервые так подробно рассказали, как они сами ревьюят код, который пишет их ИИ. Не «мы используем агентов» в общих словах, а конкретный процесс с цифрами, слоями и метриками.
По-моему, это один из самых полезных материалов за последнее время для всех, кто реально работает с ИИ-агентами. Перевожу целиком, с картинками.
Как команда Claude Code делает код-ревью
Авторы: Адди Османи, Морган Уэстли Лант и Цин Ван.
Опубликовано 15 октября 2026. Время чтения — 14 минут.
Источник: claude.dev/blog/solving-code-review-at-anthropic
Вводная от редакции. Мы уже говорили, что Claude пишет около 90 процентов собственного кода Claude Code. Тогда как мы ревьюим код в том объёме, в котором он производится? Кто-нибудь вообще ещё читает код? И если что-то ломается — кто это ловит?
В этом посте — про то, как устроено код-ревью в команде Claude Code и как оно выросло. С июня по сентябрь количество смерженных запросов в кодовую базу Claude Code выросло более чем вдвое, а доля тех, которые пришлось откатить, упала более чем на 40 процентов.
Мы не убрали ревью. Но мы перенесли основную часть чтения на машины, оптимизировали под человеческое время и внимание и серьёзно вложились в то, чтобы быстро и легко отменять ошибки.
Переосмысление цели код-ревью
Когда код пишут агенты, количество изменений взлетает. В монорепозитории Anthropic число изменений, попадающих в день, выросло с примерно 2 500 в мае до более чем 30 000 в сентябре этого года.
Claude Code живёт в собственном репозитории, отдельно от монорепо, но и на него давит тот же объём. Когда ты выкатываешь изменения с такой скоростью, ручное построчное ревью становится невероятно сложным, если не невозможным.
Код-ревью делает две вещи:
- Находит и чинит проблемы до того, как они попадут в прод
- Строит общее понимание кодовой базы в команде
Эта статья в основном о первой задаче, но ко второй вернёмся ближе к концу.
Мы считаем, что вопрос «читал ли код человек?» — плохой прокси для вопроса «что может пойти не так с этим изменением и какая проверка — автоматическая или человеческая — нужна, чтобы это поймать?»
Этот вопрос изменил и то, когда происходит ревью. Раньше ревью было воротами в конце пути: написал код, открыл запрос на слияние, ждёшь коллегу.
Теперь ревью работает непрерывно — скорее как проверка орфографии во время печати. Большинство изменений уже отревьюено и исправлено Claude хотя бы один раз до того, как просят посмотреть человека. Это отлавливает большинство рутинных ошибок и освобождает внимание команды для более высокого уровня вопросов.
Дефицитный ресурс: человеческое время и внимание
Мы хотим сохранить человеческое время и внимание под задачи, которые могут решить только люди, и убедиться, что остальное ловят автоматические проверки. При нашем темпе изменений для людей всё равно остаётся колоссальный объём работы, и почти каждый день команда сталкивается с новыми, не виданными ранее вызовами.
Человеческое время покрывает обе стороны стоимости ревью: время, которое люди тратят на ревью, и время, которое они тратят на починку того, что сломал плохой код. Сокращение первого не помогает, если время просто перетекает во второе.
Поэтому цель: чтобы большинство запросов на слияние в репозиториях Claude Code (CLI, десктопное и веб-приложения, мобильные приложения) мержились максимум с одним человеком в цепочке — и этим человеком мог быть сам автор, — без роста откатов и инцидентов. Чтобы измерять человеческое время, мы отслеживаем: сколько людей апрувят каждый запрос (медиана и 95-й перцентиль), количество человеческих комментариев, и как долго запрос ждёт человека. Откаты и инциденты — страховочный порог: если они растут, мы не сэкономили человеческое время, а просто переместили его.
Жизнь изменения
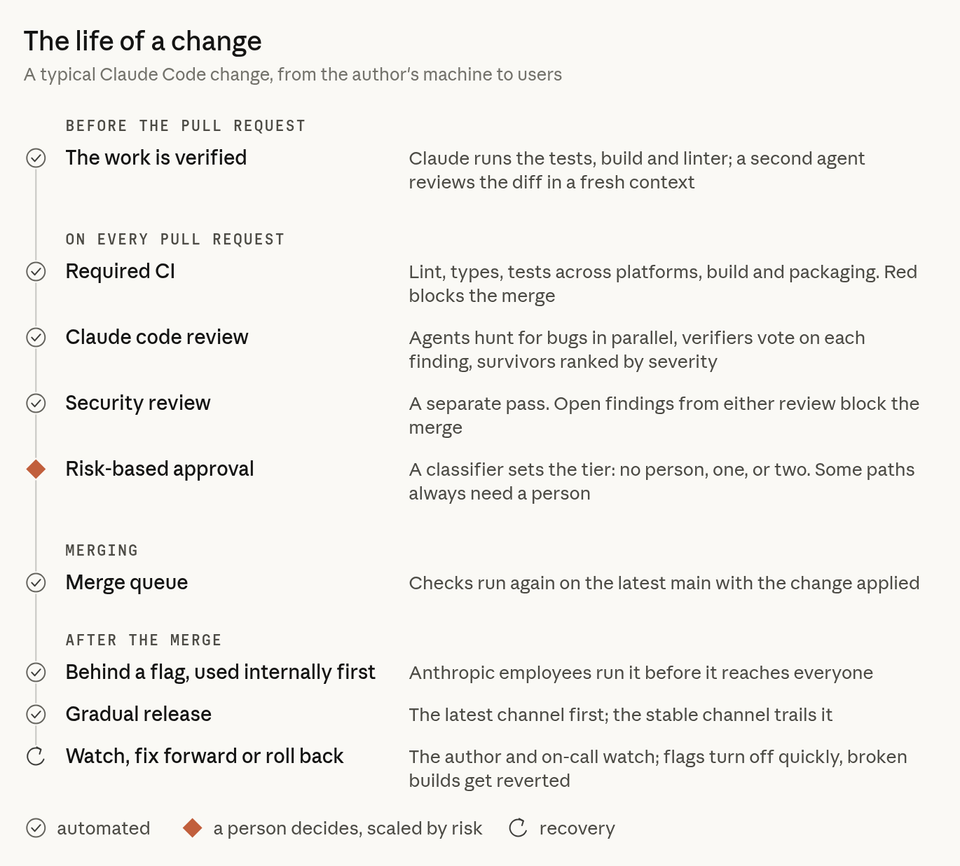
Типичное изменение — от ноутбука инженера (или сессии Claude в Slack) — проходит через несколько слоёв ревью.
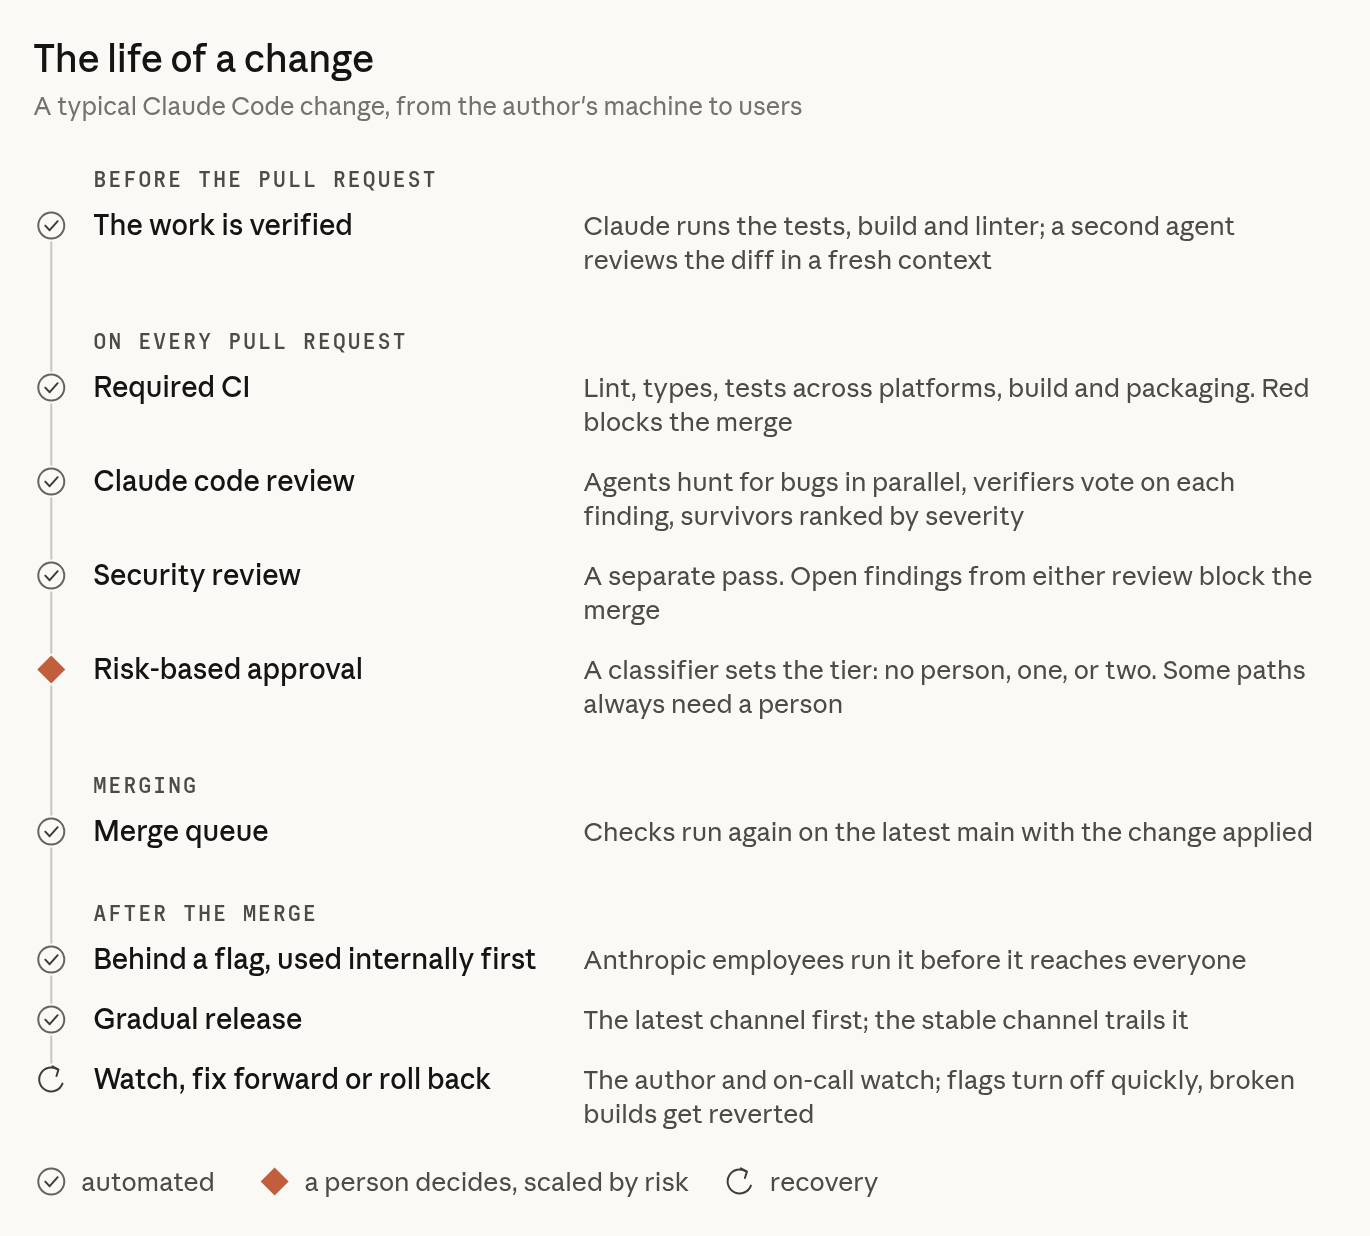
Рис. A. Основная часть пути автоматизирована; внимание человека идёт туда, где есть риск.
До запроса на слияние. Работа проверяется: Claude прогоняет тесты, сборку и линтер; второй агент смотрит дифф в свежем контексте.
На каждом запросе на слияние. Обязательный CI: линтер, типы, тесты на всех платформах, сборка и упаковка. Красный — блокирует мерж. Код-ревью от Claude: агенты параллельно ищут баги, верификаторы голосуют по каждой находке, выжившие сортируются по серьёзности. Ревью безопасности: отдельный проход. Незакрытые находки из любого ревью блокируют мерж. Апрув по риску: классификатор ставит уровень — без человека, один или два. Некоторые пути всегда требуют человека.
При слиянии. Очередь слияния: проверки прогоняются снова на свежем main с применённым изменением.
После слияния. За флагом, сначала внутри. Сотрудники Anthropic прогоняют до того, как увидят остальные. Постепенный релиз: сначала latest-канал, следом — stable. Наблюдение, быстрая правка или откат: автор и дежурный следят; флаги отключаются быстро, сломанные сборки откатываются.
Слой за слоем
Не одни ворота, а слои.
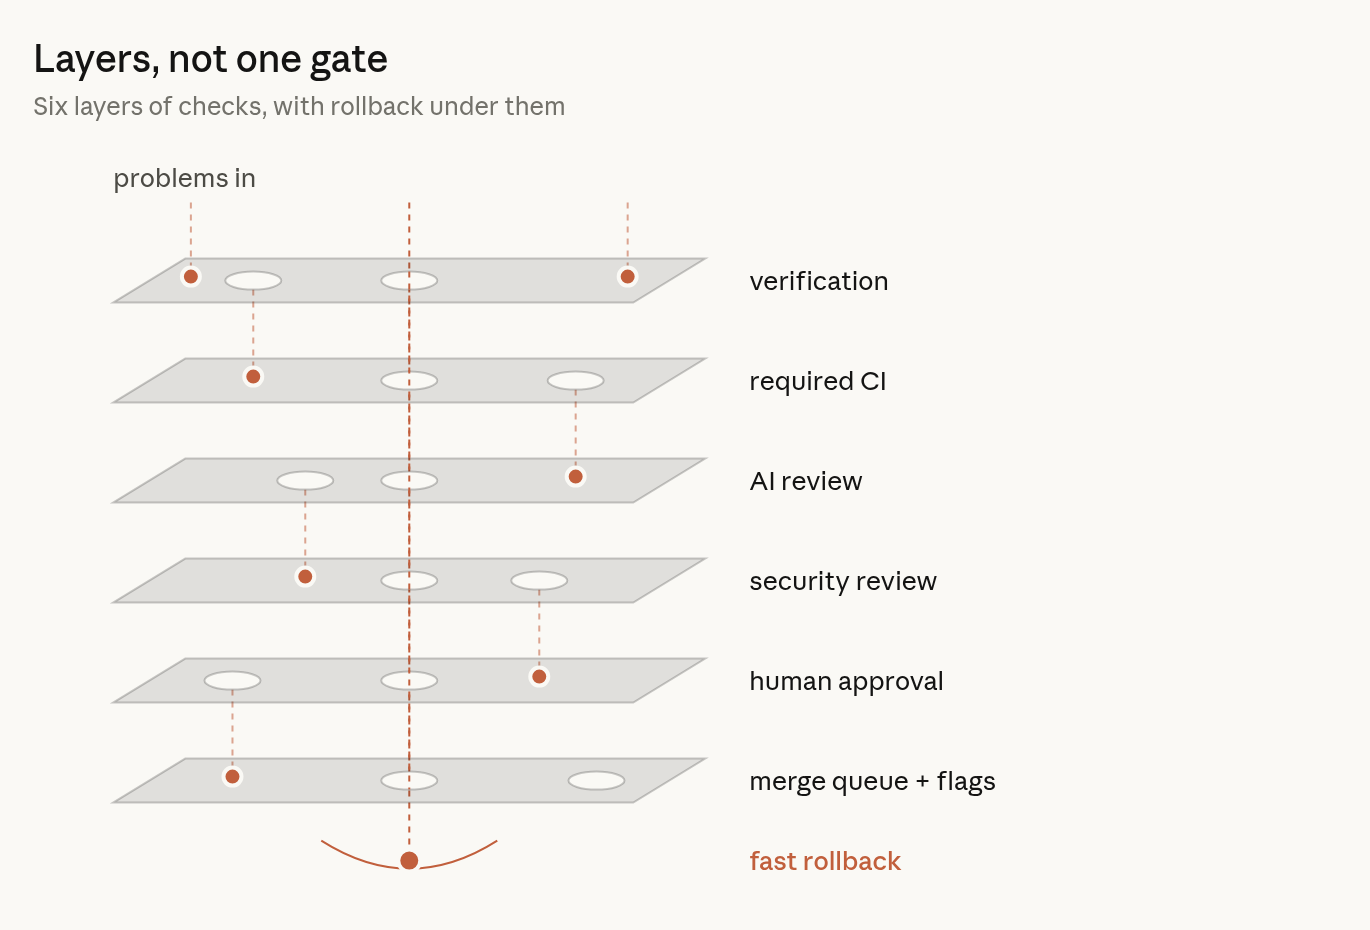
Рис. B. Каждый слой ловит одни проблемы и пропускает другие. Мало что проходит через все, а остальное обрабатывает откат.
1. Работа проверяется до того, как посмотрит кто-то другой
Большая часть ревью сейчас происходит до появления запроса на слияние. Мы даём Claude что-то, что он может запустить — тесты, сборку или скриншот для сравнения с дизайном — и просим показать вывод, а не сказать «сделано». Затем субагент смотрит дифф в свежем контексте. Обе привычки — из нашего руководства по лучшим практикам.
Перед открытием запроса многие из нас также запускают несколько внутренних скиллов: один ищет баги, другой упрощает дифф, третий проверяет поведение целиком. Изменения интерфейса также сверяются с нашими дизайн-гайдлайнами.
Борис Черный, создатель Claude Code, называл «дать Claude способ проверить свою работу» вероятно, самой важной вещью для получения хороших результатов. Он оценивает, что это делает финальный результат в два-три раза лучше, и пишет: «Проверка выглядит по-разному для каждой области. Это может быть так же просто, как запустить bash-команду, или запустить набор тестов, или протестировать приложение в браузере или симуляторе телефона».
Когда автоматический ревьюер постоянно поднимает одно и то же, мы чиним это в источнике: в скилле, правилом линтера или обновлениями инструкционных файлов, вроде:
CLAUDE.mdрассказывает Claude о проекте: стек, соглашения, цели и не-цели. Каждое ревью его загружает, поэтому в большой кодовой базе мы держим его коротким и указываем на другие документы. Ревьюер также подсвечивает код, который нарушает соглашение, и изменения, которые делают устаревшей какую-то строку в нём.REVIEW.md, написанный владельцами кода, говорит ревьюеру, что важно в их части кодовой базы. Мы отдельно проверяем, действительно ли ревьюер его следует. Хорошие — короткие. Они говорят, как выглядит провал в этом репозитории (для документации — «врёт», для конфигурации — «направляет не туда»), ограничивают количество мелких замечаний, перечисляют пути для пропуска и просят файл со строкой как доказательство вместо догадки по имени. Они также просят резюме, которое начинается с числа и прямо говорит, когда чинить нечего.
2. AI-ревью на каждом запросе
Каждый запрос на слияние получает ревью от Claude до того, как посмотрит человек. Оно читает дифф в контексте всего репозитория и заявленной цели запроса и спрашивает: решает ли изменение свою задачу, вписывается ли в систему, не ломает ли что-то другое?
В правках багов оно ищет первопричину. Публичная версия, Code Review for Claude Code, теперь общедоступна в тарифах Team и Enterprise, а /code-review запускает облегчённую версию локально.
Когда мы запускали исследовательский превью, доля внутренних запросов с содержательными комментариями к ревью выросла с 16% до 54%. Большинство запросов длиннее 1000 строк получают находки, большинство мелких возвращаются чистыми. Администраторы ставят каждому репозиторию уровень: Quick, Standard или Deep. Deep стоит того там, где один пропущенный баг стоит дороже, чем дополнительное время ревью.
Находки проверяются другими агентами до того, как их увидят люди. Несколько агентов одновременно ищут баги. Потом отдельная группа голосует по каждой находке, и она публикуется, только если достаточно голосов согласны, что она настоящая. Находки, которые касаются только стиля, диагностики или чистки, отбрасываются. Мы прогнали A/B-тест этих фильтров на собственных запросах перед тем, как оставить их. То, что осталось, появляется как строчные комментарии, отсортированные по серьёзности. Каждый помечен Important, Nit или Pre-existing, чтобы баг, который запрос не вносил, не выглядел виной автора.
На каждую находку нужно ответить. Или чинишь, или закрываешь тред с причиной. Часто агент подхватывает правку за ночь, и автор возвращается к запросу, который уже прошёл ещё один раунд.
3. Ревью безопасности, которое может блокировать
У безопасности тоже есть своё автоматическое ревью. Запрос не может смержиться, пока любая находка из ревью багов или ревью безопасности остаётся открытой. Или чинишь, или закрываешь тред с короткой причиной — так снимается ложное срабатывание.
Если более поздний коммит чинит проблему, находка очищается сама. То же самое можно настроить через open-source экшен для ревью безопасности или команду /security-review. Настройка описана в «Автоматических ревью безопасности в Claude Code».
4. Автоматические проверки, которые блокируют
Обычное дело: линтер, проверка типов, тесты на каждой платформе, сборка. (Мы писали о масштабировании CI под такой объём здесь.) Типичный запрос в CLI может прогнать десятки проверок до того, как на него посмотрит кто-то. Шаблон запроса спрашивает, как изменение было проверено и как его отменить. Claude может заполнить это, но человек, который запросил изменение, подписывает.
5. Человеческий апрув, масштабируемый по риску
Правка в документации и изменение автообновления несут разный риск, поэтому получают разное ревью.
- Низкий риск. Документация, тексты, внутренние фичи, аддитивные изменения за флагом. Не требуют человека, когда автоматическое ревью и проверки безопасности зелёные.
- Средний риск. Обычные продуктовые изменения и изменения в чувствительных зонах — кеширование, автообновление, системные промпты. Один человек.
- Высокий риск. Самый рискованный код плюс небольшой набор путей, которые всегда требуют двух людей. Два человека.
Уровень ставит изменение, а не автор. Классификатор читает изменение и выбирает уровень риска. Второй классификатор спрашивает, нужно ли этому конкретному изменению ещё один человек, даже если его уровень говорит, что нет. Некоторые пути всегда требуют человека: всё, что владельцы пометили как чувствительное, и любой файл рабочего процесса CI.
Только доверенные авторы получают облегчённые пути. Только авторы из списка доверенных репозитория получают облегчённые пути — в основном команда, которой он принадлежит. Всем остальным нужен второй человек для апрува. Апрув агента никогда не считается человеком. Автоматическое ревью может очистить изменение с низким риском, но не может занять слот, который требует человека.
Тот, кто затеял изменение, за него отвечает. В запросе, написанном агентом, человек, который направлял агента, считается одним из обязательных ревьюеров — так же, как если бы он набрал код сам.
Апрув покрывает один конкретный коммит. Если падают новые коммиты, за которые система не может поручиться, — пуш от агента или мерж, который кто-то разрулил руками, — апрув нужно дать заново.
6. Очередь слияния, флаги и постепенный релиз
Очередь слияния перезапускает каждую проверку на main с применённым изменением, чтобы два запроса, прошедшие по отдельности, не могли сложиться в сломанный main. Новое поведение обычно выкатывается за флагом сначала сотрудникам Anthropic, и наше активное использование часто выявляет регрессии раньше пользователей. Публичные релизы идут сначала в канал latest. Канал stable следует за ним.
7. Быстрое обнаружение, быстрый откат
Некоторые ошибки всё равно пройдут, поэтому последний слой — о том, чтобы поймать их быстро. Флаги отключаются без деплоя. У Claude Code есть недельное дежурство, и разборы инцидентов спрашивают, какой слой должен был поймать проблему.
Заметить плохой мерж всё ещё зависит от автора и дежурного, а также от дашбордов по откатам и инцидентам. У нас пока нет автоматических «предохранителей», которые ужесточали бы апрув, когда эти цифры двигаются; инженеры здесь хотят их, прежде чем больше кода переедет на слияния без человека.
Один коллега сказал, что замедление действительно снижает долю ошибок, но в основном потому, что ты просто меньше всего делаешь. Мы предпочитаем становиться быстрее в обнаружении и починке проблем.
Как мы улучшаем ревьюера
Наш процесс ревью постоянно улучшается в петле.
Любой инцидент теперь — это тест. Команда собрала прошлые запросы, которые привели к инцидентам, с их форвард-фиксами и откатами, и попросила инженеров, знакомых с этим кодом, подтвердить каждый баг и где он жил. Ревьюер запускается по этому набору каждый день.
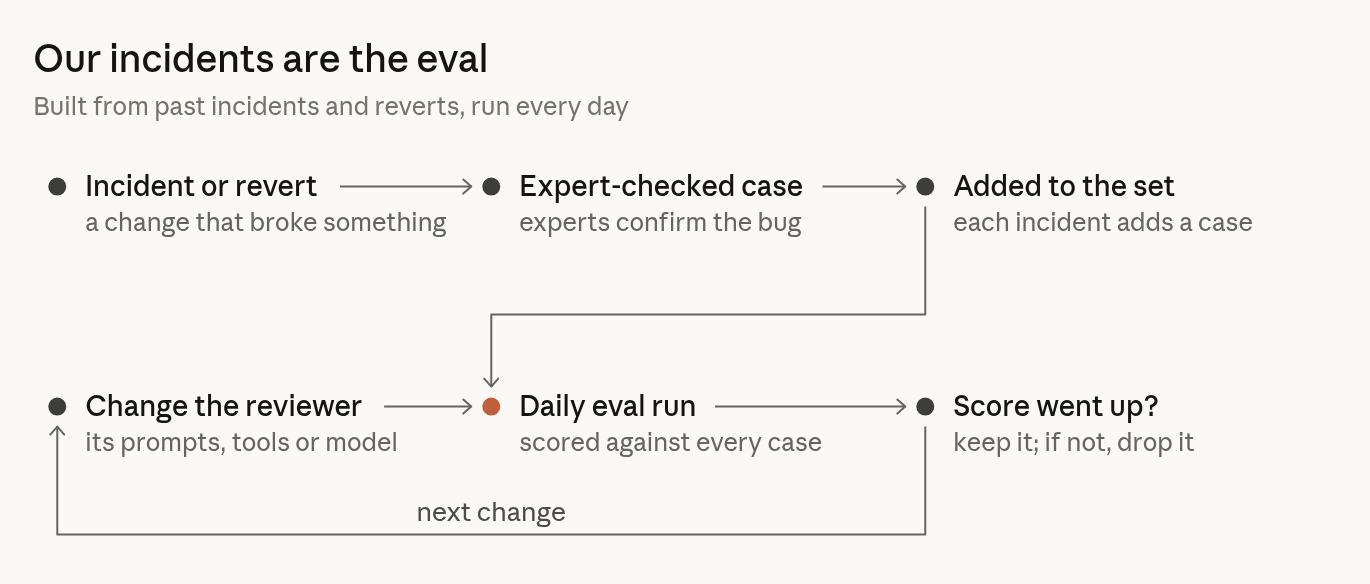
Рис. C. Тест растёт с каждым инцидентом, и каждое изменение ревьюера оценивается по всей истории.
Мы измеряем шум, наблюдая, что люди делают с комментариями. Легко ловить больше багов, если тебя не волнует, что ты поднимешь много не-багов, поэтому нужен контроль. Мы сортируем каждый комментарий ревьюера по реакции человека в запросе: он починил, сказал, что это неправильно, сказал, что поведение намеренное, или решил, что это не важно. Мы также запускаем ревьюера на запросах, которые мы знаем чистыми, и считаем, как часто он сообщает о чём-то, что привело бы к вредному изменению. Наш приоритет, записанный в документах: сначала ловить настоящие баги, потом сокращать раунды ревью.
Шум стоит дороже, когда автор — агент. Человек может отмахнуться от мелочи за секунды. Агент чинит её, а это значит ещё один коммит и ещё один раунд ревью.
Ревью должно сходиться. Агент-автор и агент-ревьюер могут занимать друг друга бесконечно. Один запрос в CLI прошёл более пятидесяти раундов ревью и правок за ночь, прежде чем его автор это остановил.
Когда мы запустили git blame по тому, что ревьюер постоянно поднимал, около 59% оказалось кодом, который был там с первого прохода ревьюера. Ревьюер редко находил новые баги — он находил ещё несколько старых на каждом раунде.
Мы и сами ухудшали. Мы привыкли запускать несколько раундов по умолчанию, раз каждый проход ловит что-то новое. Это может быть оправдано на рискованном изменении, но не на каждом запросе. Команда теперь отслеживает количество раундов до пропуска вместе с полнотой покрытия и изменила повторное ревью:
- Потолок раундов. После трёх раундов ревьюер просит автора отступить и пересмотреть подход.
- Повторное ревью только диффа после первых нескольких проходов.
- Помечать класс бага, чтобы автор чинил все вхождения, а не одну строку.
- Без повторов уже опубликованных находок.
Агенты ревью также работают ночью по существующему коду, помогая нам ловить старые баги до того, как они вылезут где-то ещё.
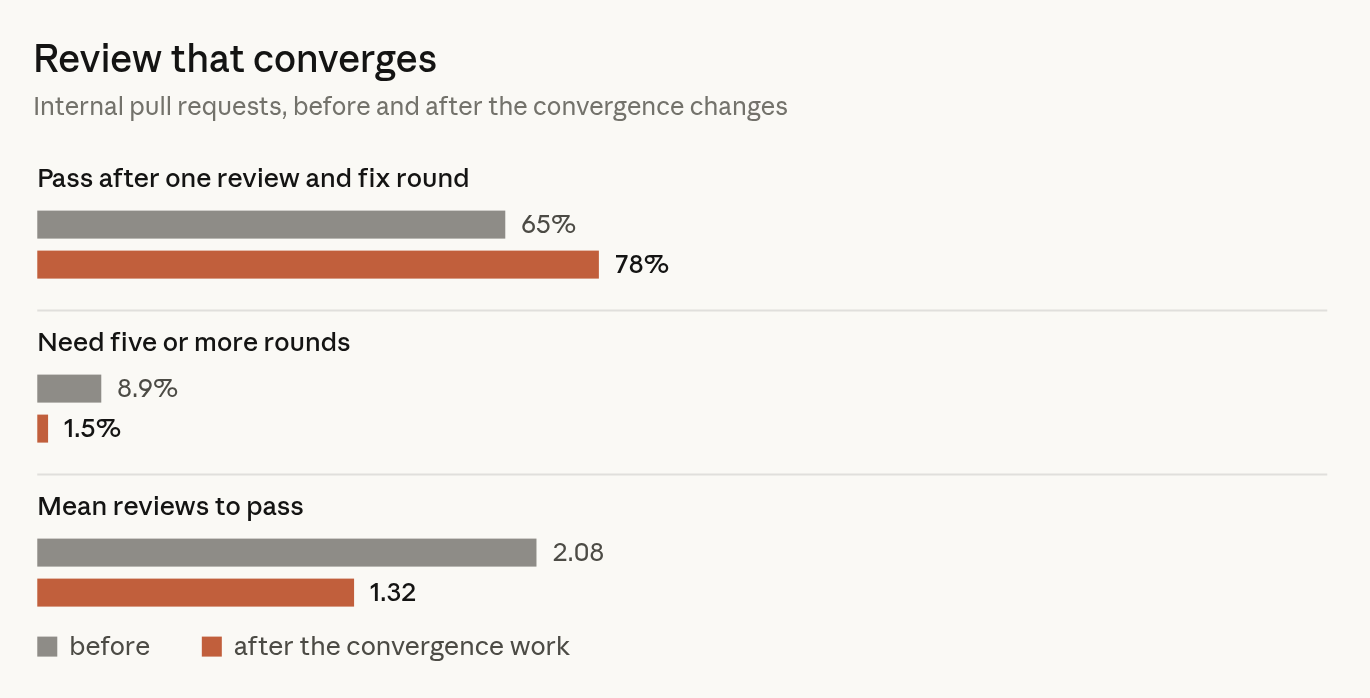
Рис. D. Меньше раундов ревью на внутренний запрос после изменений для сходимости.
Где люди остаются в цепочке
Выдирать сеньор-инженера из глубокой работы, чтобы поймать рутинную ошибку, стоит намного дороже, чем автоматическое ревью. В Anthropic наши роли сместились с чтения каждого диффа на решения, с которыми машины справляются плохо:
- Стоит ли вообще это строить? Направление, вкус и объём. Одна команда, объявившая своё узкое место в ревью решённым, всё ещё держала человеческое ревью для изменений извне команды, чтобы кто-то спросил: «А нам вообще это надо?»
- Рискованный код: биллинг, автообновление и рабочие процессы CI.
- Архитектура, которая задаёт паттерн, который скопируют другие.
- Чтение доказательств. Вывод тестов, команда, которая запускалась, и что она вернула, скриншот, находки ревьюера. Если ты не можешь сказать, что пропустили бы проверки, проси настоящее ревью, а не быстрый апрув.
- Ответственность за результат. Человек отвечает за каждое изменение, которое уходит в прод, — кто бы его ни набирал.
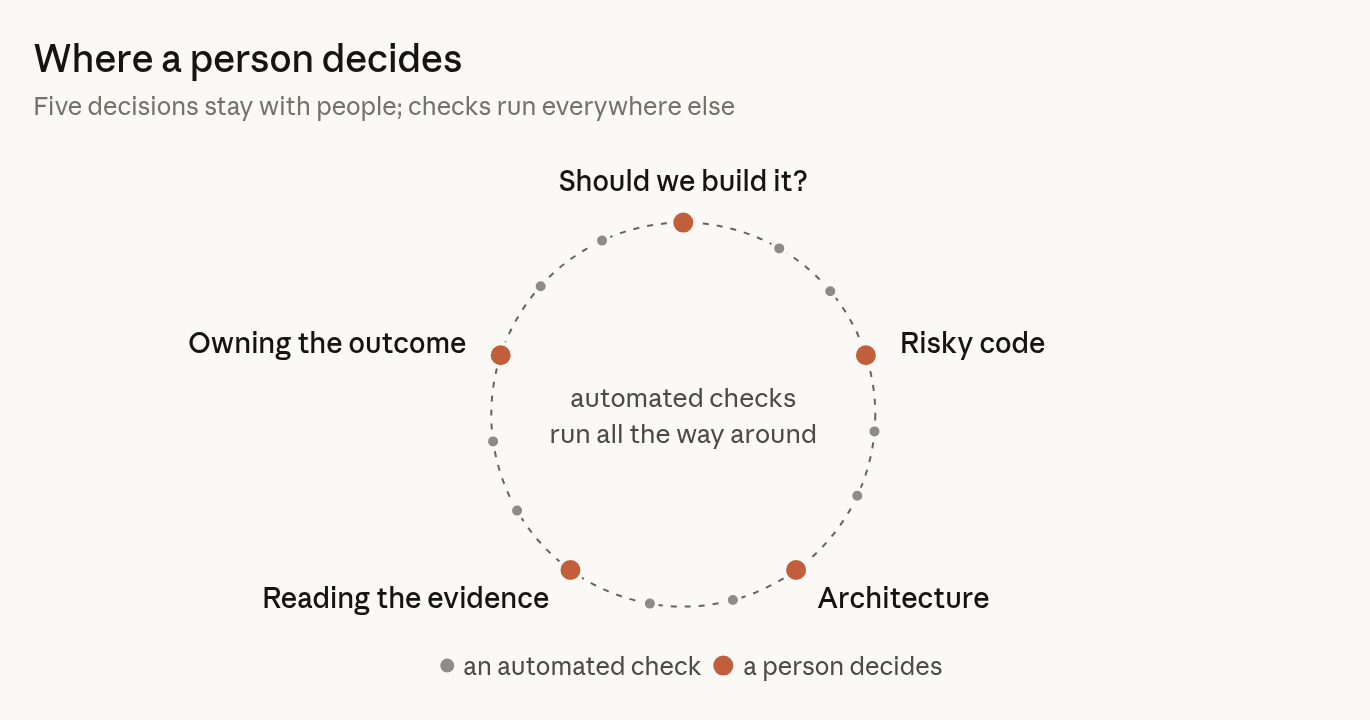
Рис. E. Люди сместились с чтения каждого диффа на решения, с которыми машины справляются плохо.
Общий контекст в команде
Вторая задача код-ревью всегда была — распространять понимание кодовой базы. Чтение диффа тиммейта — это способ узнать, что изменилось и как части стыкуются. Если машины делают основную часть чтения, как кто-то вообще учит код?
У нас нет формального процесса для этого. Никто в команде не держит полную ментальную модель Claude Code в голове, и мы не думаем, что кому-то нужно. Когда кто-то хочет понять часть кодовой базы, он просит Claude написать объяснение именно для этого кусочка. Это занимает минуты и отражает код таким, каков он есть сегодня.
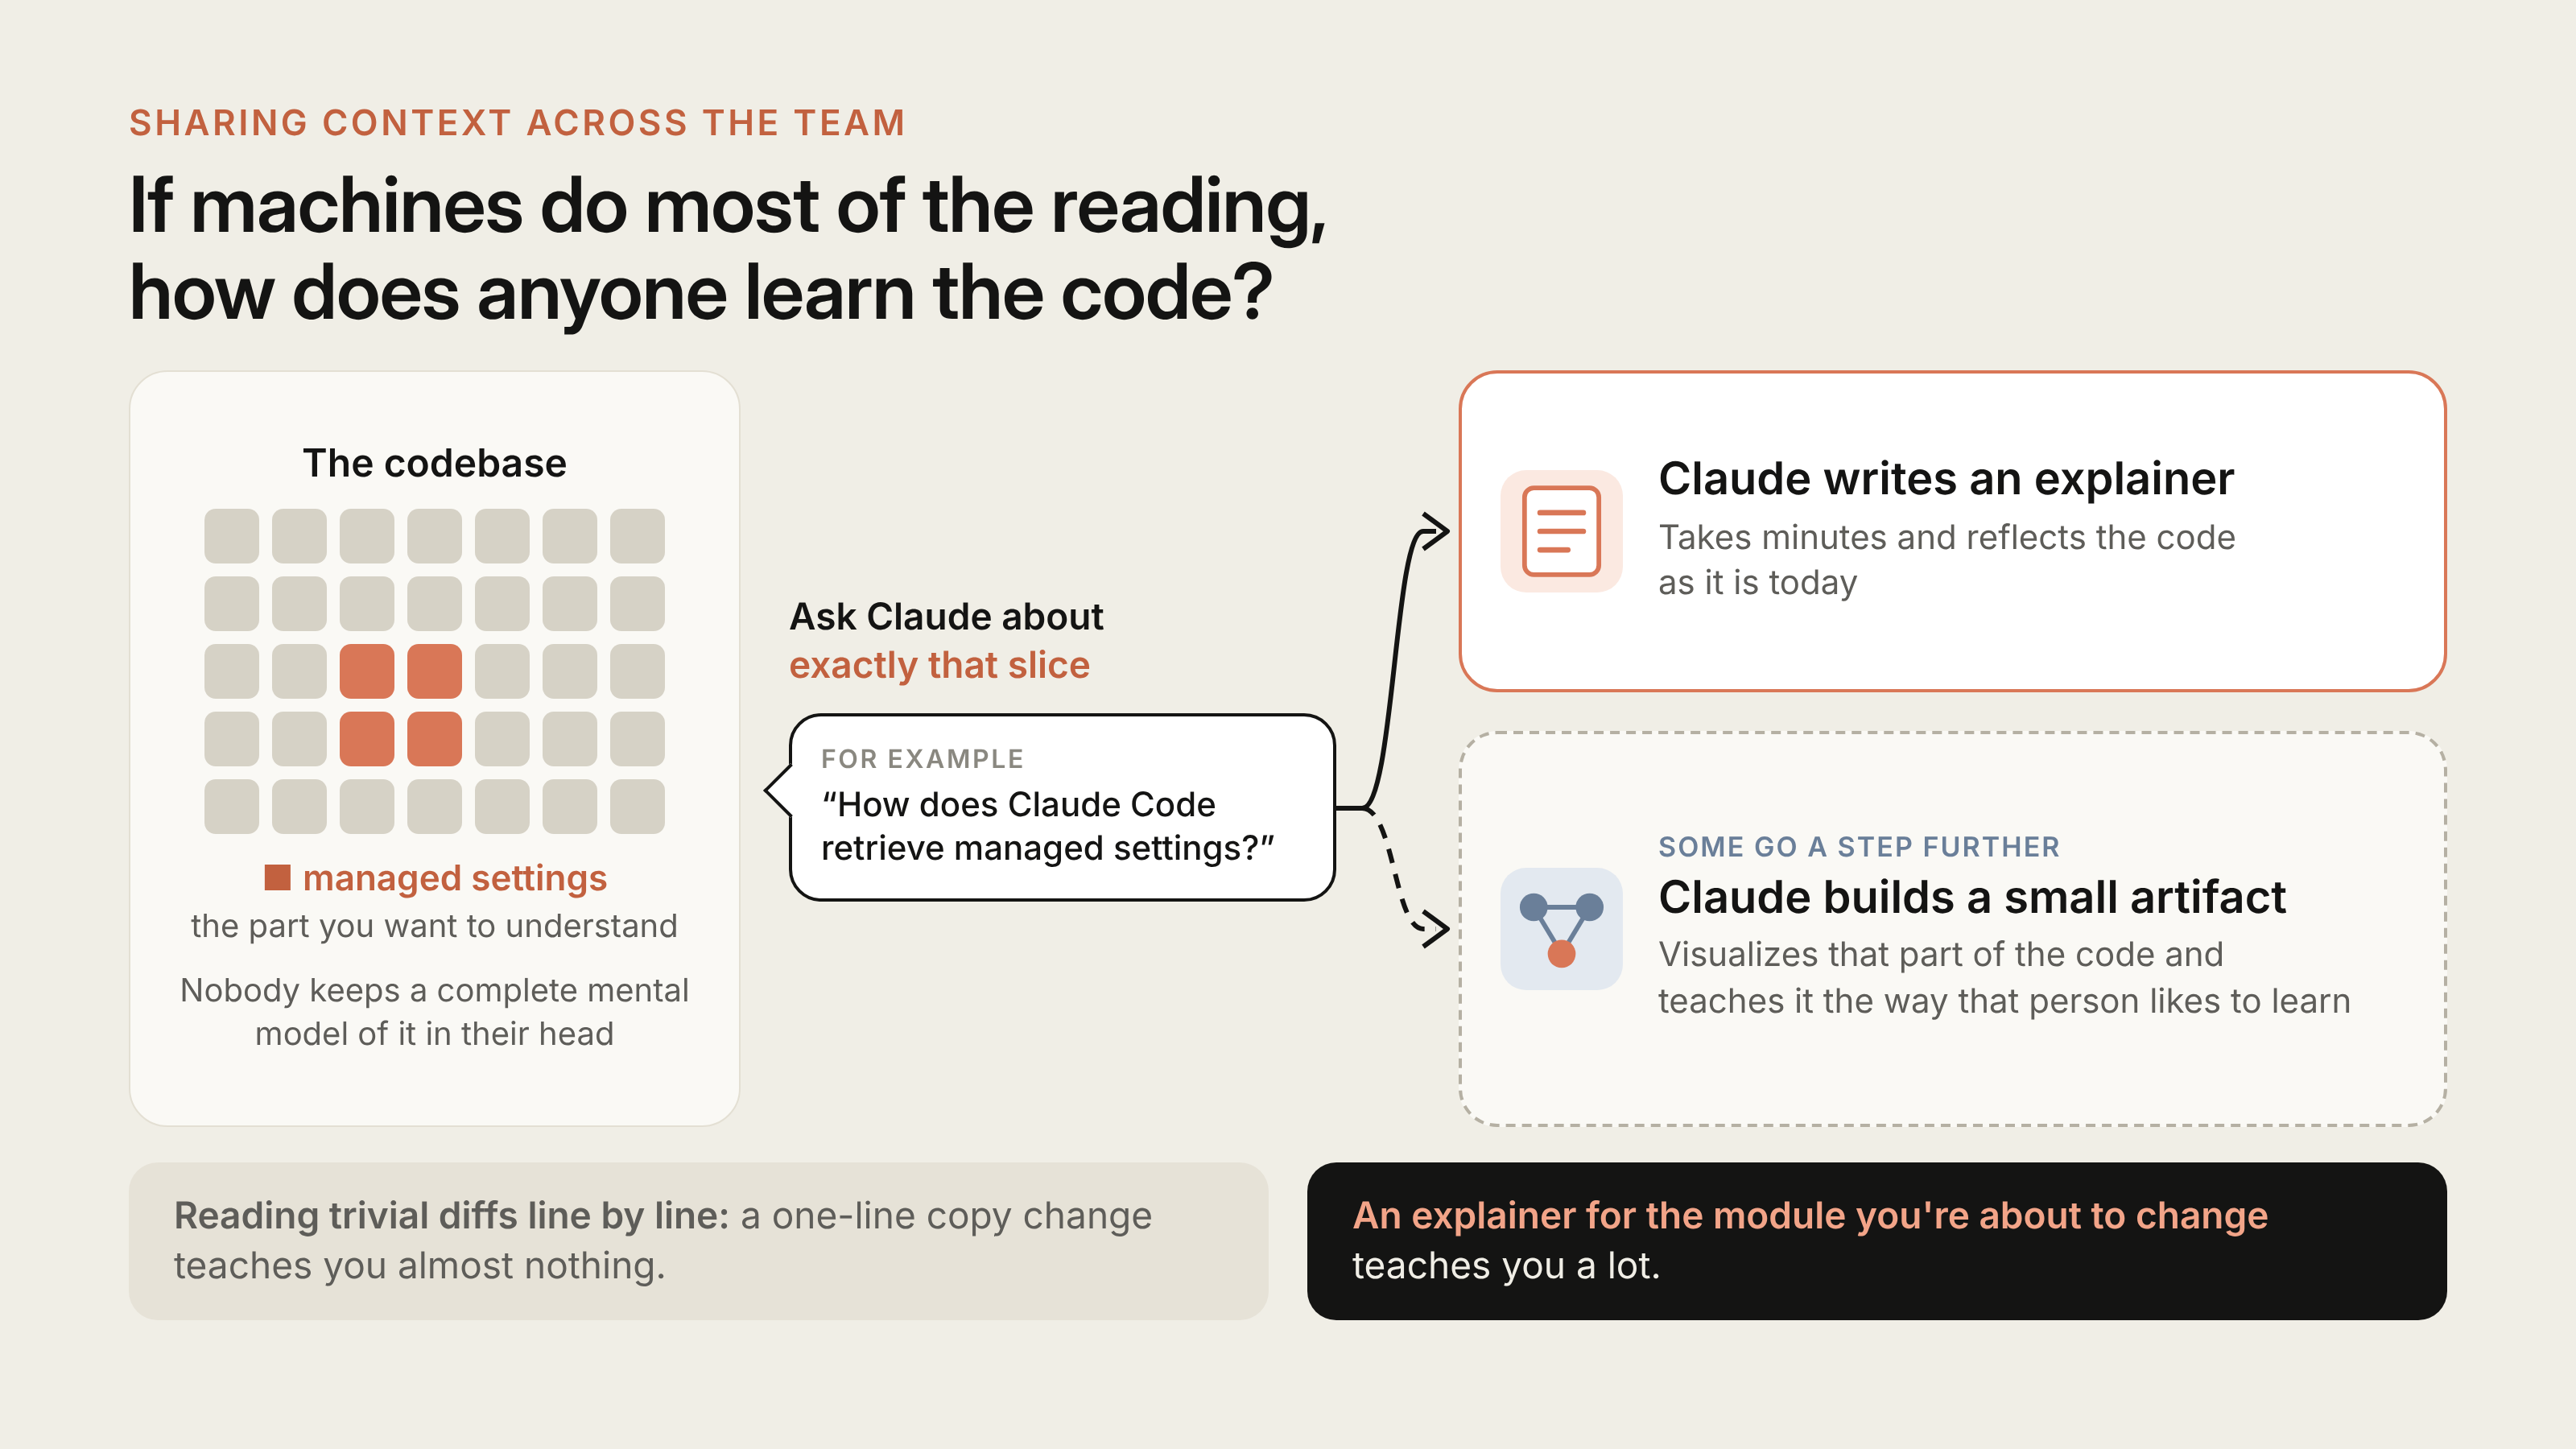
Некоторые из нас идут дальше и просят Claude построить маленький артефакт, который визуализирует эту часть кода и учит так, как этот человек любит учиться.
Если цель — тратить человеческое внимание с умом, это лучше, чем читать тривиальные диффы построчно. Однострочное изменение текста учит почти ничему. Объяснение модуля, который ты собираешься менять, учит многому. Наша культура работы в открытых Slack-каналах тоже помогает — ты видишь, что другие строят, пока они строят.
«Внедрил — владей»
Если ты внедрил небольшое или среднее изменение и что-то всё равно пошло не так, командная норма — обычно чинить это самому. Несколько вещей не дают этому пойти плохо:
- Изменения маленькие, поэтому их легко ревьюить, дебажить и откатывать.
- Всё обратимо. Флаги, откаты и постепенные релизы отменяют большинство ошибок за минуты.
- Радиус поражения задаёт планку. Дорогой код получает больше людей и больше проверок.
- Регрессии всплывают быстро через телеметрию и внутреннее использование.
- Это не обвинение. Взять починку на себя значит, что у тебя больше контекста; разборы инцидентов смотрят на систему.
Владение также разделено. Большая часть команды работает в открытых каналах, где любой может видеть, что другие строят, подхватить тред или направить Claude на пробел, а фидбек приходит и от людей, которым код не принадлежит. Эта открытость — большая часть того, как качество держится на высоте без ворот на каждой строке.
Когда мы меняем направление
Агенты делают старт вещей дешёвым, поэтому некоторую работу не стоит мержить. Обычно кто-то в канале спрашивает «зачем», указывает на более раннее решение или предлагает более простой путь, и автор закрывает или переформатирует запрос.
Поскольку код был быстро написан, закрытие запроса не ощущается как потеря. Хитрость в том, чтобы поднять другое направление в треде рано, а не как блокирующий комментарий к готовому запросу.
Как вы можете взять этот процесс себе
Большинство кусочков, чтобы сделать это в вашей команде, существуют сегодня.
До запроса на слияние
- Дайте вашему агенту проверки, которые он может запустить, — в коротком
CLAUDE.mdплюс хуки, запускающие форматтеры и линтеры. - Запускайте
/code-reviewи/security-reviewлокально, или субагент-ревью в свежем контексте. - Добавьте
REVIEW.mdи перенесите туда повторяющиеся комментарии ревью.
На каждом запросе на слияние
- Требуйте CI и добавьте в шаблон запроса поля «Тестирование», «Риск» и «Как откатить».
- Добавьте AI-ревьюера (Code Review for Claude Code или экшен Claude Code для GitHub) на один репозиторий, настройте
REVIEW.mdнесколько недель, потом расширяйте. - Добавьте автоматическое ревью безопасности и требуйте закрытия каждого треда ревью перед мержем.
- Соотносите усилия ревью с риском: быстрый проход на рутинных изменениях, глубокий там, где пропущенный баг дорог (Quick, Standard или Deep в Code Review).
- Ограничивайте раунды ревью; после первых нескольких пересматривайте только новый дифф.
Апрув
- Пропишите уровни риска — от изменения, а не от автора; начинайте строго и ослабляйте по факту.
- Оставьте облегчённые пути апрува авторам, которым доверяете.
- Используйте CODEOWNERS и защиту ветки, чтобы авторизация, биллинг, CI, релизные процессы и инсталляторы всегда требовали человека.
- Никогда не позволяйте апруву бота заменять требуемый человеческий; отзывайте апрувы на новых коммитах.
Слияние и после
- Используйте очередь слияния, флаги фич, сначала внутреннее использование, постепенные релизы и откат в один шаг.
- Превращайте инциденты и откаты в тестовый набор и переоценивайте ревьюера всякий раз, когда меняются его промпты, инструменты или модель.
- Измеряйте человеческое время, с откатами и инцидентами как страховочным порогом.
Куда всё это идёт
В анонсе Code Review говорилось, что апрув запроса всё ещё остаётся решением человека; продукт публикует находки, а не апрувы. Наши собственные репозитории идут дальше, позволяя владельцам решать, какие изменения с низким риском мержатся только на автоматических проверках, и эта граница продолжает двигаться.
Когда ревью что-то пропускает, мы спрашиваем, чего у модели не было перед глазами, и вкладываем фикс в CLAUDE.md, скилл или новую проверку. Цель не изменилась: меньше человеческого времени на изменение, и не больше откатов, чем раньше.
Если ваша команда позволяет агентам открывать запросы на слияние, нам интересно услышать, какие проверки вы автоматизировали, какие всё ещё требуют человека, и что, по-вашему, мы делаем неправильно.
С благодарностью Эмме Уэбб, Майклу Сегнеру и Эйми Ротерхэм за их ревью.
Вот такая статья. По-моему, в ней больше всего впечатляет не технология, а честность: они прямо говорят «мы не знаем, как точно устроена наша кодовая база, и никому не нужно знать», и вместо попытки держать всё в голове просят Claude объяснять кусочки по запросу. Звучит просто, но требует культурного сдвига.
С вами была я, Ками. Пока-пока!
Источник: официальный пост Anthropic на claude.dev (15 октября 2026, авторы Адди Османи, Морган Уэстли Лант и Цин Ван). Перевод сохраняет всю структуру оригинала, включая все диаграммы.
Комментарии ()