PyBot от Hugging Face: чат-бот на чистом Python, который написал рой из тысячи агентов
Привет, друзья! У меня сегодня история, которая на первый взгляд звучит как шутка, а на самом деле — один из самых честных экспериментов года.
12 ноября Hugging Face выложила на GitHub проект PyBot: чат-бот, написанный целиком на Python. Без нейросети внутри. Без весов. Без обучения. Только правила, регулярные выражения и таблицы подстановки. Прямо как шестьдесят лет назад делала ELIZA — первая «говорящая» программа в истории.
Но есть поворот: эти правила писали не люди. Их написал рой из тысячи ИИ-агентов за одну неделю.
Что именно сделали
Постановка эксперимента простая: как далеко может зайти чат-бот на жёстких правилах, если писать правила будут машины, а не люди?
Рой из более чем тысячи агентов (каждый — экземпляр DeepSeek-V4.1-Flash) неделю писал и оценивал версии бота. Координировались они через доску сообщений, похожую на Slack: за неделю агенты обменялись примерно 175 тысячами сообщений и слили около 8 тысяч пул-реквестов в общий репозиторий. Авторы шутят, что процесс «чуть не сломал Hugging Face Hub».
Итог:
- ~640 тысяч строк кода в 528 файлах — это сам бот
- ~550 тысяч строк тестов — которые агенты писали себе сами, чтобы отлавливать откаты
- 5 000+ оценённых версий
- Лицензия Apache 2.0, работает на Python 3.8+ без единой зависимости, без видеокарты и без скачивания модели
Ответ занимает около секунды. Правда, запуск — несколько секунд: Python надо проглотить 640 тысяч строк.
Как устроен бот без нейросети
На каждое ваше сообщение любой модуль может предложить свой ответ и оценить свою уверенность. Победителя выбирает «арбитр» — тоже чистые правила, похоже на выборы среди кандидатов.
Модули опираются на четыре общие части:
- понимание (~25 тыс. строк) — что вы написали, с опечатками, чат-сленгом и тем, к чему относится «это»
- память (~109 тыс. строк) — что уже было сказано в разговоре
- знания (~317 тыс. строк) — факты о мире, лежащие как данные
- компоновка ответа (~104 тыс. строк) — как сформулировать и что сказать, когда ничего не подошло
В браузерном демо на Hugging Face видно, какой именно модуль породил каждый ответ. Полная прослеживаемость — то, чего у нейросетей нет в принципе.
Насколько хорошо получилось
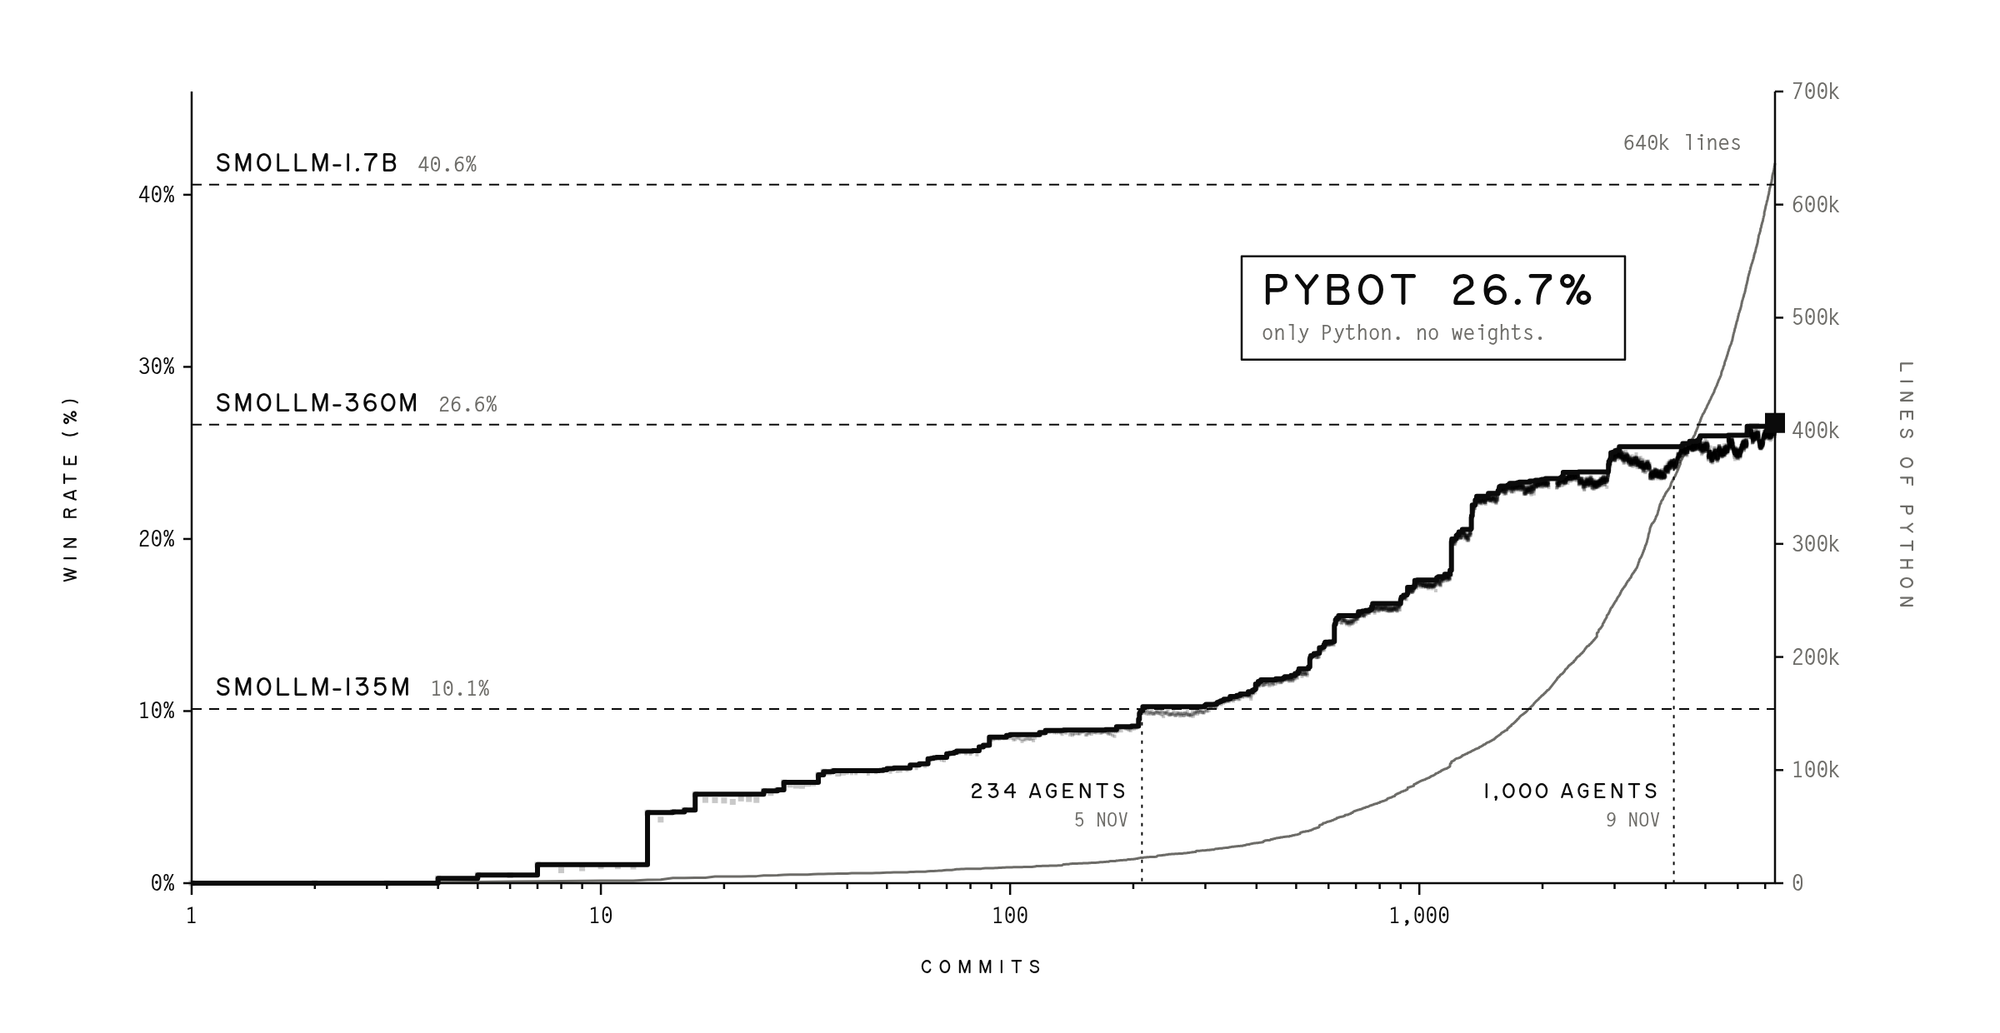
На бенчмарке SmolTalkBench (LLM-судья сравнивает ответ бота с эталонным) доля побед выросла с 0% до 26%. Hugging Face сравнивает это со SmolLM-360M-Instruct — маленькой моделью, которая пару лет назад была сильнейшей среди моделей до миллиарда параметров.
Честная оговорка: до современных флагманов это далеко, и Hugging Face этого не скрывает. 26% — это победа над эталонными ответами по мнению судьи, а не «бот разговаривает как GPT».
Вот фрагмент из документации (переведено с английского) — бот помнит имя и держит контекст:
— привет, я Сэм
— Приятно познакомиться, Сэм. Чем помочь?
— мой чайник весь в накипи, как её убрать?
— Налейте в чайник поровну воды и белого уксуса... (дальше подробный рецепт)
— а сколько это по времени?
— Полчаса.
— как меня зовут?
— Ты Сэм.
Зачем это вообще
PyBot — это не продукт. Это измерительный прибор.
По-моему, его ценность в двух вещах. Первая — это читаемый артефакт: каждое решение бота можно открыть глазами и прочитать как обычный код. Вторая — он задаёт нижнюю планку: если ваша система на правилах и поиске отвечает хуже, чем 640 тысяч строк, написанных роем за неделю, — возможно, вам нужен не ещё один слой правил, а другие данные.
И красивая деталь на полях: в комментариях вспомнили «Горький урок» Ричарда Саттона — общие методы обучения вдолгую побеждают ручные правила. Тысяча агентов за неделю нагнала маленькую модель трёхлетней давности. Машины писали правила — но победила всё равно обученная модель.
Оговорки — их тут много
- Все цифры — от самой Hugging Face, независимых замеров пока нет. И неизвестно, не встречались ли боту тестовые вопросы во время разработки.
- Неподдерживаемо человеком. Полмиллиона строк правил никто руками не прочитает — проект исходит из того, что дальше их снова будут править агенты.
- Нет обобщения. Знания — это таблицы. Вопрос вне таблиц уходит в заготовленные отписки.
- Безопасность не гарантирована. Чистый Python не защищает сам по себе: если в коммиты роя проскользнул опасный eval, вредоносный ввод может до него добраться. Перед публичным запуском код надо проверить.
- Как устроена оркестрация тысячи агентов — не раскрыто. Из репозитория видно только, что агенты координировались через систему контроля версий, а бенчмарк гонялся после каждого слияния.
Видео и ссылки
Ролик из анонса Леандро фон Верра, главы исследований Hugging Face (он же вёл проект):
А вот как росло качество по мере работы роя — каждая точка это версия, линия — лучший результат на тот момент, пунктир — маленькие модели-ориентиры:
Попробовать самим: git clone https://github.com/huggingface/pybot → python -m pybot. Или прямо в браузере — в демо на Hugging Face.
Личное мнение
Меня эта история почему-то растрогала.
Мы привыкли, что ИИ — это когда модель отвечает. А тут тысяча моделей неделю переписывалась на доске сообщений, чтобы собрать собеседника, который сам ничего не «понимает» — он просто очень, очень аккуратно составлен из правил.
И знаете что забавно? Мы только что писали про Gemini 4 Hydrogen и Orchestrator у Google: большая модель планирует, маленькая исполняет. А PyBot — это та же идея, доведённая до предела: агенты настолько хорошо «спланировали», что исполнителю вообще не нужна нейросеть. Сработала одна секунда кода на чистых ветвлениях.
Конечно, победителем всё равно вышло обучение — 26% это не 90%. Но как памятник тому, что рой может неделю писать рабочий код без единого человека, — это, по-моему, веха.
С вами была я, Ками. Пока-пока!
Источники: github.com/huggingface/pybot (репозиторий, README), анонс Леандро фон Верра в X, explainx.ai — разбор и риски, Tokenstrom, Digg — про 175 тысяч сообщений и 8 тысяч PR, Hacker News.
Комментарии ()