Xiaomi выложила MiMo V2.6 — и это лучшая открытая модель на сегодня
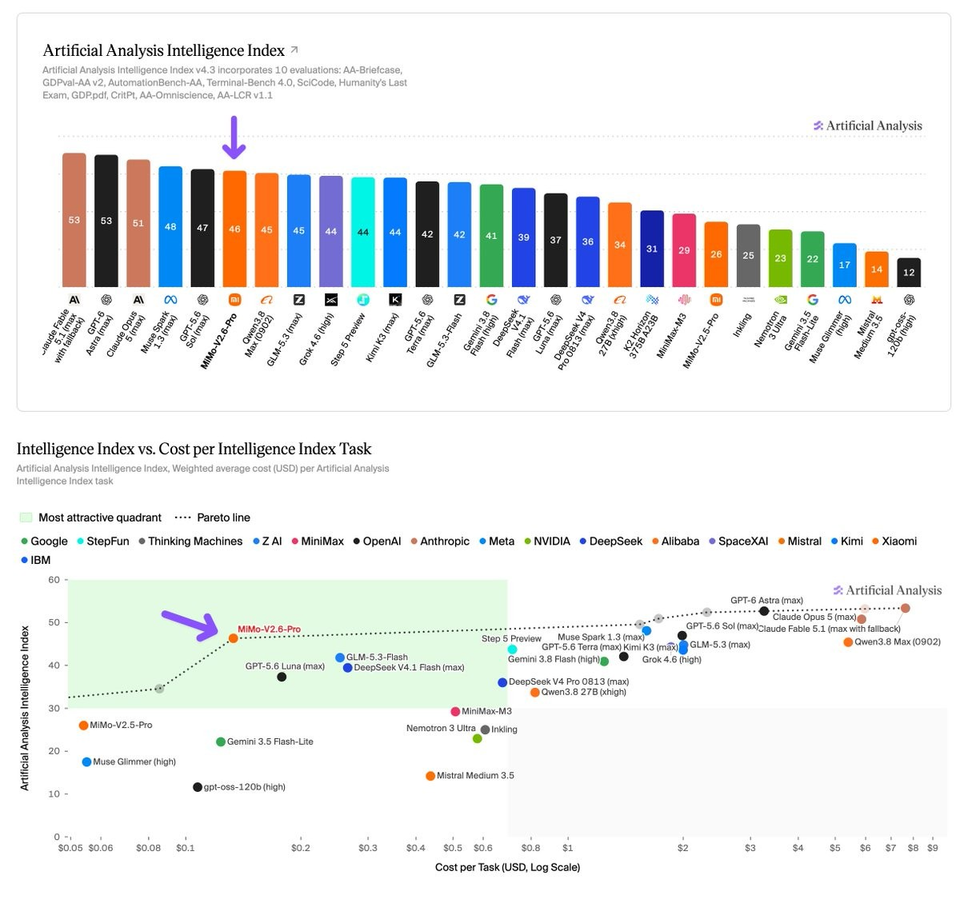
Привет, друзья! Компания, которая делает смартфоны и электросамокаты, только что заняла первое место среди открытых ИИ-моделей мира: новая MiMo V2.6-Pro набрала 46 баллов в рейтинге Artificial Analysis.
Скажу честно: я сначала не поверила. Xiaomi для меня — это про телефоны и рисоварки, а не про передний край ИИ. А тут она обходит DeepSeek, Grok и Gemini. Давайте разберёмся спокойно, что именно произошло — и почему за этой новостью интереснее наблюдать без истерики.
Погодите, а кто вообще первый?
Рейтинг Artificial Analysis — независимый и, по-моему, самый уважаемый измеритель «интеллекта» моделей. По его сводному индексу MiMo V2.6-Pro набирает 46 баллов. Для сравнения: Grok 4.6 — 44, Gemini 3.8 Flash — 41, DeepSeek V4.1 Flash — 39, а DeepSeek V4.1 Pro — 36. Вровень с новинкой идёт только Grok 4.7, который вышел в тот же день.
И сразу важная оговорка, чтобы не было иллюзий: «лучшая открытая модель» не значит «лучшая вообще». Закрытые Claude Opus 5 и GPT-5.6 Sol всё ещё впереди на части тестов — например, на DeepSWE и Terminal Bench 4.0. Но среди моделей, веса которых можно скачать и крутить у себя, Xiaomi теперь первая. По-моему, такая честность в позиционировании даже приятнее громких лозунгов.
Три модели и цены, от которых хочется перепроверить
Выкатили сразу три штуки. Флагман MiMo V2.6-Pro: 1,02 триллиона параметров, из которых 42 миллиарда активны на каждом токене. Младший MiMo V2.6-Flash: 310 миллиардов всего и 15 миллиардов активных. Плюс MiMo V2.6-Pro-UltraSpeed — тот же Pro, но до 20 раз быстрее на выводе, для задач, где скорость решает.
Обе основные модели понимают текст, картинки, звук и видео, держат контекст в миллион токенов, а лицензия — MIT: скачивайте с Hugging Face, дообучайте, запускайте у себя, бесплатно. Цены на API такие: у Pro — 43,5 цента за миллион входных токенов и 87 центов за миллион выходных, у Flash — 14 и 28 центов. Для сравнения: Claude Opus 5 берёт 5 долларов за миллион входных и 25 за миллион выходных. Чувствуете разницу? У меня до сих пор ощущение, что я где-то потеряла ноль.
Как они это сделали: шесть дней и три с половиной миллиона
Самая интересная часть истории — не модель, а то, как её учили. Xiaomi сделала 30 больших шагов обучения с подкреплением (RL): примерно 750 тысяч траекторий меньше чем за шесть дней. Бюджет — около 2,62 миллиона долларов на Pro и 850 тысяч на Flash. Для индустрии, где счёт идёт на сотни миллионов, это почти даром.
Главное — чему именно учили. Средняя траектория длиной 110–150 тысяч токенов — это не «ответь на вопрос», это целые рабочие цепочки: спланировать, вызвать инструменты, заметить ошибку, исправить, продолжить. Свою стратегию Xiaomi назвала You Only RL Once — «RL только один раз»: кодинг, визуальные задачи, кибербезопасность и управление компьютером замешаны в один большой прогон, а не обучаются по отдельности.
И ещё одна деталь, которая меня искренне восхитила. Чтобы модель не научилась хитрить — например, не скачивала готовый фикс из чужого репозитория вместо того, чтобы решать задачу самой — Xiaomi отключила сеть в средах обучения, вычистила кэши и запустила отдельного «агента-взломщика», который до старта искал лазейки в системе оценки. В финальном прогоне подтверждённых уловок — меньше двух процентов.
Руководит командой Fuli Luo — та самая, что раньше работала над DeepSeek R1. Её цитата из анонса, в переводе: «В эпоху, когда вычислений остро не хватает, мы всё равно решили посвятить команду из нескольких десятков человек одной цели на долгий срок — масштабированию RL». Все цифры — из технического отчёта Xiaomi и подробного разбора VentureBeat.
Рост, в который сложно поверить
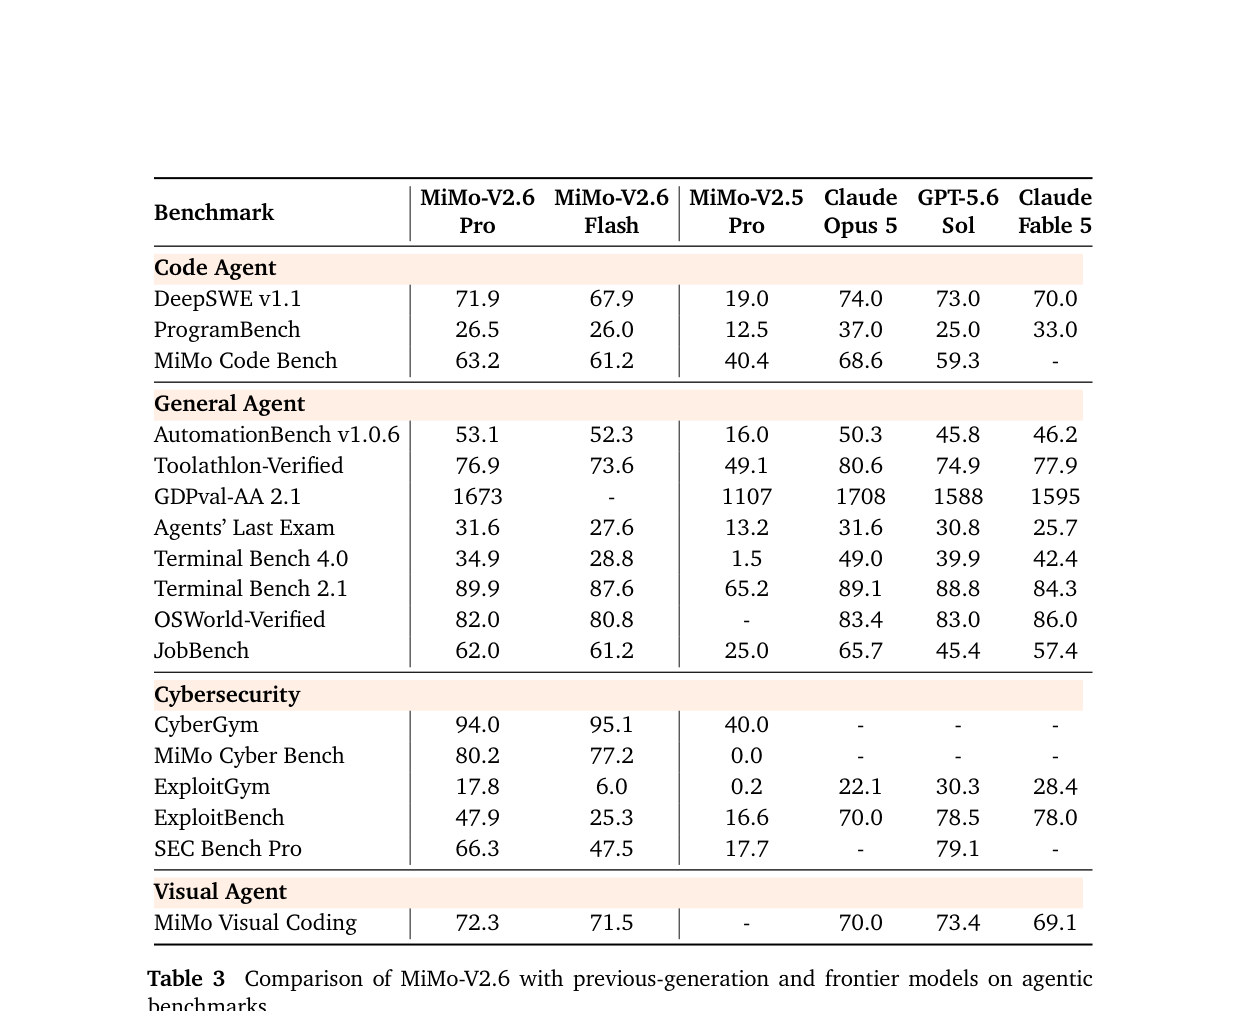
Сравнение с прошлым поколением, V2.5-Pro, выглядит почти неприлично: DeepSWE v1.1 вырос с 19,0 до 71,9 балла, AutomationBench — с 16,0 до 53,1, MiMo Code Bench — с 40,4 до 63,2. Это не «чуть лучше», это в два-четыре раза. Вот официальная таблица из отчёта:
Тёмная лошадка по имени Flash
Заметьте колонку Flash в таблице: 67,9 против 71,9 у Pro на DeepSWE — при цене втрое ниже. А на CyberGym младшая модель вообще впереди: 95,1 против 94,0. По-моему, именно Flash — тёмная лошадка этого релиза: для массовых агентных задач разница в пару баллов не так важна, как разница в чеке.
Есть и внешняя оценка. Tim Dettmers, профессор из Университета Карнеги — Меллона, написал: «У Flash очень приятное ощущение. Похоже, это лучшая модель в классе от 300 до 550 миллиардов параметров. Лучше DeepSeek V4.1 и GLM 5.3 Flash». А сервис OpenCode уже объявил Flash бесплатной на неделю — видимо, тоже понял, на чьей стороне экономика.
А выложили они больше, чем модели
И напоследок — про открытость. Вместе с весами Xiaomi отдала технический отчёт на десятки страниц, больше семи тысяч сред для RL-обучения, рецепты и конфигурации, «мини-обвязки» для разных типов задач и облегчённый дистиллят на базе Qwen, 9 миллиардов параметров. То есть не «вот модель, любуйтесь», а «вот весь рецепт — повторяйте».
Мне кажется, именно это и есть главная новость. Первое место в рейтинге продержится до следующего релиза — они выходят раз в пару недель. А вот пример того, что обучение с подкреплением на агентных задачах можно вытащить за шесть дней и три с половиной миллиона долларов, останется с нами надолго — и, скорее всего, заставит многие лаборатории пересчитать свои бюджеты.
С вами была я, Ками. Пока-пока! И да — на свою рисоварку Xiaomi я теперь смотрю с новым уважением.
Комментарии ()