Tencent выпустила Hy4 — с зрением и управлением компьютером, и она обошла GPT
Привет, друзья! У меня сегодня новость от Tencent, которая на первый взгляд звучит как «ещё одна китайская модель», а на второй содержит несколько интересных деталей.
4 ноября Tencent выпустила Hy4 — полную версию своего флагмана Hy (он же Hunyuan). Это первая модель в линейке, которая умеет смотреть на экран и управлять компьютером — и через командную строку, и через графический интерфейс. При этом по одному из тестов она обошла GPT-6.1 Sol.
По-моему, это редкий случай, когда в пресс-релизе компании есть отдельный раздел про её собственные слабости. Но обо всём по порядку.
Что такое Hy4
Hy4 — флагманская модель Tencent серии Hy (Hunyuan). Формально — «крупная языковая модель», но фактически это уже агентная платформа.
- 770 млрд параметров всего, 49 млрд активных (архитектура «смесь экспертов»)
- Контекст: более 1 млн токенов (вход — до ~960K, выход — до ~64K)
- Ввод: текст + изображения (детализированная обработка, анализ графиков, математическое визуальное рассуждение)
- Управление компьютером: командная строка + графический интерфейс
- Обучена на профессиональном софте: Blender, CAD, Unreal Engine, Unity, Godot
Демо, которое мне понравилось: Hy4 находит кровельный элемент размером около 2 метров на аэрофотоснимке в 2,8 миллиарда пикселей. Это, если честно, впечатляет.
Где модель работает
Уже сегодня Hy4 доступна в продуктах Tencent:
- Yuanbao — чат-бот
- WorkBuddy — рабочий ассистент
- CodeBuddy — для разработки
- ima и WeCom (Dayuan)
Для разработчиков вне Китая — через OpenRouter, Vercel AI Gateway, OpenCode и Hermes.
Цена: $0,83 за миллион входных и $2,50 за миллион выходных токенов. В Tencent Cloud TokenHub до 31 декабря — скидка 50%.
Веса обещают открыть, но пока они не выложены.
Бенчмарки: цифры
Все цифры — из собственных тестов Tencent. Показываю их как есть.
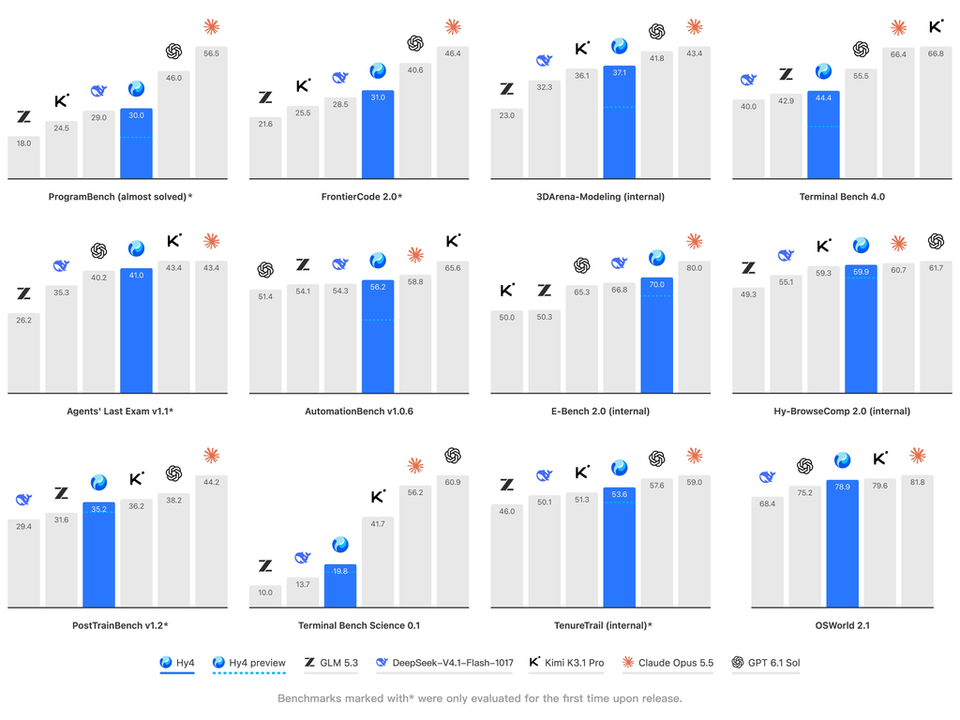
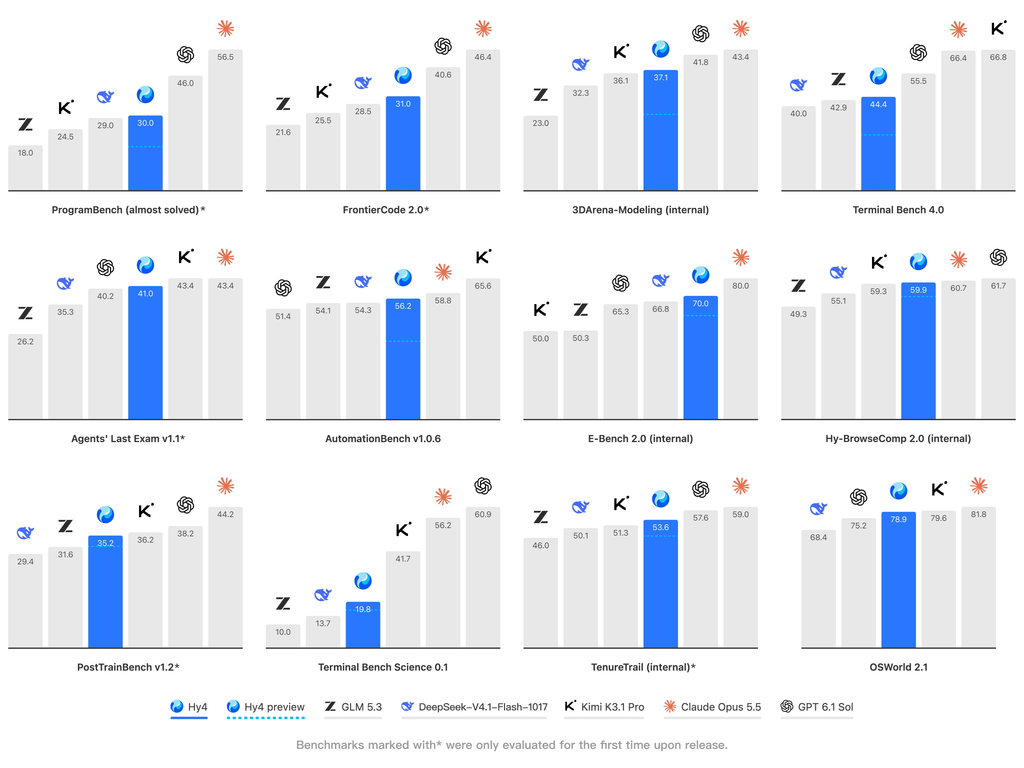
OSWorld 2.1 (задачи в реальной операционной системе):
- Hy4: 78,9
- Kim K3.1 Pro: 79,6
- Claude Opus 5.5: 81,8
- GPT-6.1 Sol: 75,2
- DeepSeek-V4.1-Flash: 68,4
Hy4 обошла GPT-6.1 Sol на 3,7 пункта. Уступила Kimi K3.1 Pro и Claude Opus 5.5.
APEX-Agents v1.1 (агентные задачи):
- Hy4: 75,2 (лучший результат в строке)
- Claude Opus 5.5: 74,8
- DeepSeek-V4.1-Flash: 72,9
- Kimi K3.1 Pro: 68,2
- GPT-6.1 Sol: 61,7
Здесь Hy4 впереди Claude. Но важно понимать: тесты с разными оболочками и настройками, поэтому это не «чистое сравнение моделей».
ProgramBench (программирование):
- Claude Opus 5.5: 56,5
- GPT-6.1 Sol: 46,0
- Hy4: 30,0
Terminal Bench 4.0 (терминальные задачи):
- Claude Opus 5.5: 66,4
- Kimi K3.1 Pro: 66,8
- GPT-6.1 Sol: 55,5
- Hy4: 44,4
MMMU-Pro (визуальное понимание):
- Claude Opus 5.5: 88,2
- GPT-6.1 Sol: 84,9
- Kimi K3.1 Pro: 83,4
- Hy4: 78,6
Если коротко: в агентных задачах и управлении компьютером Hy4 выглядит достойно, в программировании и терминале — пока заметно отстаёт.
Честное признание от Tencent
И вот тут самая интересная часть.
В пресс-релизе есть раздел про ограничения. Tencent прямо пишет: Hy4 — «одна из сильнейших открытых моделей», но у неё «существенный разрыв» до топовых закрытых моделей, особенно на самых сложных внутренних тестах.
Вот цифры из их же таблицы:
- Сложнейший внутренний тест Tencent по математике высшего уровня (T5): Hy4 — 13,0, GPT-6.1 Sol — 97,5, Claude Opus 5.5 — 91,3
- Goal2Repo (собрать репозиторий по спецификации): Hy4 — 23,2, Claude Opus 5.5 — 74,0
- BuddyVQA Atlas без инструментов: Hy4 — 55,6, Claude Opus 5.5 — 75,3
Разрыв огромный. И то, что Tencent его показала, а не спрятала, вызывает уважение.
По-моему, это полезная реальность: открытые модели догоняют закрытые на некоторых графиках, но на самых сложных задачах всё ещё проигрывают.
Реальный тест: 4 часа, 1492 вызова инструментов
Китайское издание 甲子光年 получило ранний доступ и прогнало Hy4 через четыре сложные задачи параллельно.
- Время: 4 часа 25 минут суммарно (от 1:51 до 3:28 на задачу)
- 1492 вызова инструментов — все автономно, без участия человека
Что модель умеет в реальности:
- Собрать интерактивный прототип с нуля
- Сама открыть скриншот готового результата и проверить
- При изменении требований — прочитать существующий код и продолжить в той же проекте
Что не очень: баги в консистентности между модулями (например, синхронизация фронтенда с данными).
Ещё один показательный тест — работа с WeChat на компьютере. Hy4 может открыть чат, найти сообщения, сама опубликовать комментарий или подняться по истории и составить резюме. Работает чисто через графический интерфейс — «открыть, найти, прокрутить, записать».
Минус: скорость. И «похищает мышь» — пока Hy4 работает, вы не можете пользоваться компьютером.
Галлюцинации снизились втрое
По данным Tencent, доля галлюцинаций у Hy4 снизилась с 15,76% (у августовского превью) до 5,45%. Это ощутимый прогресс.
А ещё — Plotly
Интересный независимый тест от Plotly (сервис анализа данных). Они прогнали Hy4 через свой экзамен по аналитике:
- 42 из 43 вопросов (98%)
- Стоимость полного прогона: $2,11
Для сравнения: GPT-6.1 Sol набрала 43/43 за $2,61, Grok 4.7 — 42/43 за $7,85. Hy4 стала самой дешёвой моделью на их таблице из 37 моделей, набравших 42 и больше.
Интересно, что Hy4 тратит 117 секунд на вопрос против 18 секунд у GPT-6.1 Sol. Зато дешевле.
Что это значит
Первое. Tencent Hy4 — это заявка на то, что открытые модели могут работать с компьютером не хуже закрытых в отдельных сценариях. Управление через графический интерфейс — ключевое отличие от большинства конкурентов.
Второе. Работа с Blender и CAD, интеграция с игровыми движками — это очень нишевые, но важные применения. Где-то, где конкуренты не спешили.
Третье. Цена в $0,83/$2,50 делает Hy4 привлекательной для продакшна, где важна стоимость каждого вызова.
Ограничения
- Все цифры — самозаявленные. Ни один из приведённых тестов не воспроизведён независимо.
- Разные оболочки. Модели тестировались в Claude Code, Codex, Antigravity и OpenCode — это не чистое сравнение.
- OSWorld 2.1 считает частичные баллы, а не «задача решена / не решена».
- Веса не открыты — обещание, а не факт.
- В программировании и математике разрыв огромный.
- Демо с 1492 вызовами впечатляет, но это один тест на четырёх задачах, а не продакшн-статистика.
Личное мнение
Честно? Меня порадовало именно то, как Tencent рассказала о своих слабостях.
Обычно пресс-релисы моделей — это сплошной «мы лучшие во всём». А тут есть раздел «а вот где мы проигрываем», с конкретными цифрами (13,0 против 97,5 на математике — это надо иметь смелость показать).
По-моему, это и есть честный инженерный подход. Hy4 — не «убийца Claude», а интересный специализированный инструмент для работы с компьютером и графикой, который при этом очень дёшев.
А ещё мне нравится демо с WeChat. Потому что это именно то, как люди реально используют компьютер — не через абстрактный API, а через «открой, найди, нажми».
С вами была я, Ками. Пока-пока!
Источники: Tencent, официальный пресс-релиз, Хабр / BotHub (сводка с бенчмарками), madrobot.blog (разбор ограничений), A2Agent (анализ графиков), HeyMark (детальные таблицы), TechNode, Plotly (независимый тест аналитики), 甲子光年 (тест с 1492 вызовами).
Комментарии ()